


Graph RAG indica un approccio alla generazione aumentata dal recupero (Retrieval-Augmented Generation) che integra informazioni testuali e relazioni strutturate in un grafo. La sua utilità emerge quando una risposta non può basarsi sulla sola somiglianza fra una domanda e un documento: deve anche rispettare vincoli, versioni, dipendenze e fonti verificabili.
Il confronto fra RDF e labeled property graph (LPG) è spesso presentato come una scelta di campo. Nei sistemi applicativi, però, la domanda più utile riguarda le responsabilità dei singoli componenti: dove definire il significato dei dati, dove conservare i fatti, come recuperarli e come impedire al modello linguistico di inventare una risposta quando non dispone di evidenze sufficienti.
Prendiamo un caso concreto: confrontare abbonamenti e funzionalità di piattaforme SaaS soggette a regole differenti, prezzi che cambiano e clausole di conformità. Qui una semplice lista di frammenti di testo può essere insufficiente. Un’architettura ibrida può invece collegare i contenuti a un modello del dominio, mantenere traccia delle fonti e applicare controlli prima di generare la risposta.
Sommario
- Tre significati diversi di semantica
- Ontologie operative: che cosa significa
- Un’architettura Graph RAG ibrida
- JSON Schema come ontologia minima
- Neo4j e grafi a proprietà con vincoli
- Postgres, fonti e gestione delle versioni
- Weaviate e ricerca ibrida
- Fusione gerarchica e generazione della risposta
- Quando scegliere RDF e quando LPG
- Le domande da porre prima di progettare
- Verso una semantica verificabile
1. Tre significati diversi di semantica nel Graph RAG
Una ricerca può definirsi “semantica” per ragioni molto diverse. Conviene distinguere tre piani, perché ciascuno risolve un problema specifico e nessuno sostituisce automaticamente gli altri.
1.1 Semantica formale: RDF, RDFS e OWL
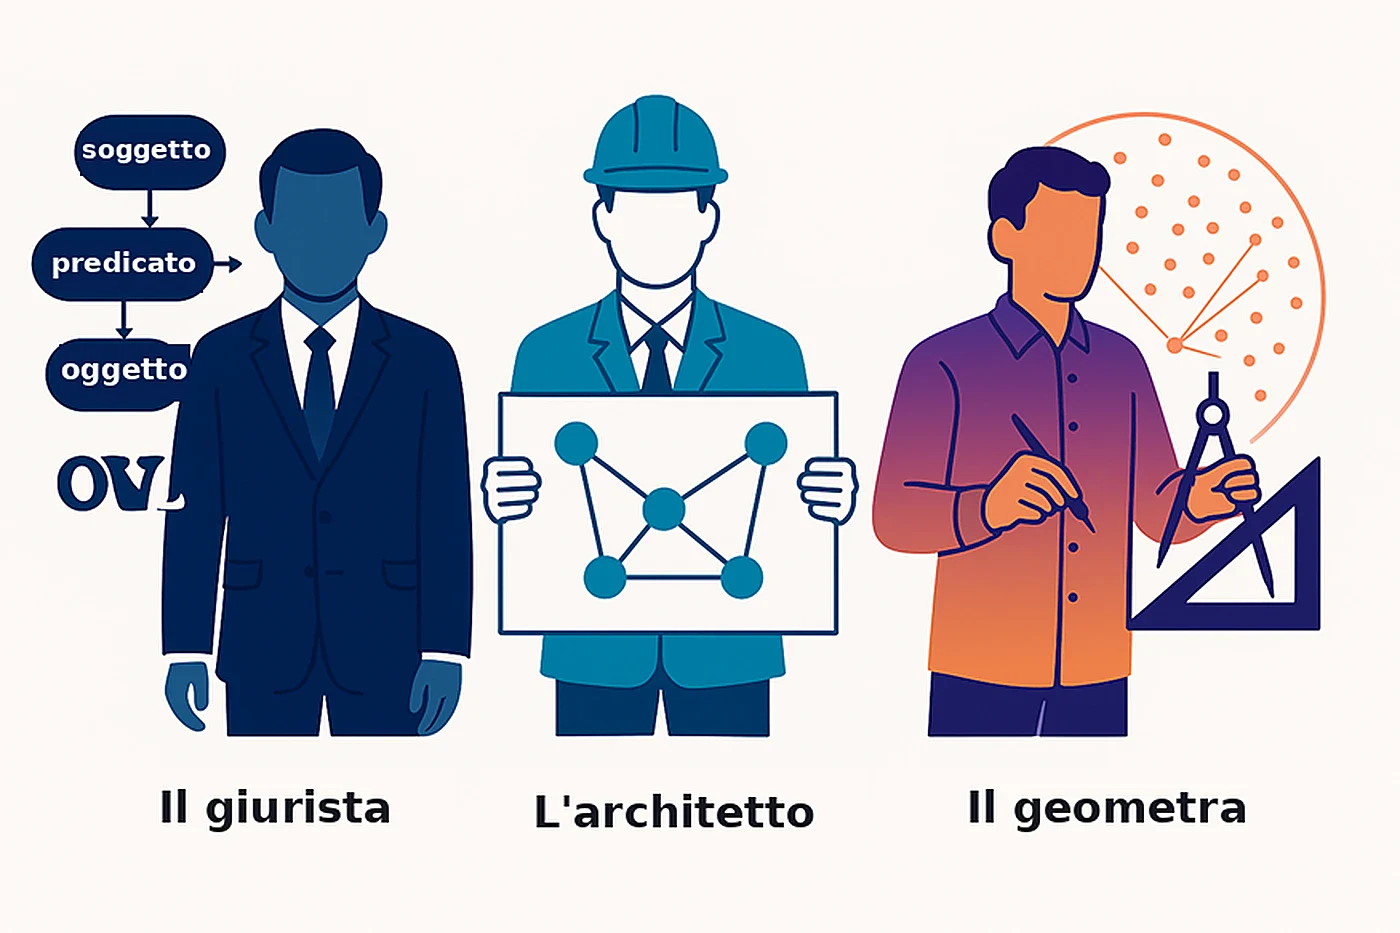
Con RDF un’informazione viene rappresentata come una tripla: soggetto, predicato e oggetto. Per esempio, l’affermazione «il piano Premium include la funzione esportazione» può diventare una relazione esplicita fra entità. Con vocabolari e regole adeguati è possibile definire classificazioni e ricavare conseguenze logiche dai dati dichiarati.
Questa precisione è utile quando l’interoperabilità, la coerenza fra organizzazioni o i vincoli normativi richiedono definizioni condivise e inferenze controllabili. Non significa, però, che ogni sistema di ricerca aziendale debba adottare l’intero stack RDF/OWL.
1.2 Semantica strutturale: grafi a proprietà e relazioni tipizzate
Nei grafi a proprietà etichettate i dati sono organizzati in nodi, relazioni e proprietà. Una società può offrire un prodotto; un prodotto può includere più piani; ciascun piano può supportare funzioni specifiche, con limiti e condizioni.
Le relazioni diventano utili quando i tipi di nodo e di collegamento sono definiti con attenzione. Un grafo senza regole rischia invece di trasformarsi in un deposito di etichette difficili da interpretare. La struttura, da sola, non garantisce l’intero ragionamento formale di OWL, ma permette verifiche e interrogazioni precise.
1.3 Semantica statistica: embedding e vicinanza fra testi
I modelli di embedding trasformano contenuti e domande in rappresentazioni numeriche. La vicinanza nello spazio vettoriale aiuta a trovare passaggi potenzialmente pertinenti anche quando usano parole diverse. È uno dei meccanismi centrali della ricerca semantica moderna.
Un risultato semanticamente vicino, tuttavia, non è necessariamente aggiornato né corretto rispetto a un determinato piano commerciale o a una condizione contrattuale. Per questo il recupero vettoriale e la verifica strutturata possono essere complementari.
2. Che cosa sono le ontologie operative
Un’ontologia descrive quali entità esistono in un dominio, come sono collegate e quali vincoli ne regolano le relazioni. In un progetto reale, il punto è rendere questo modello utilizzabile sia da persone sia da software.
Immaginiamo un catalogo di servizi digitali. Prima di rispondere a una domanda su compatibilità e condizioni, il sistema deve riconoscere concetti quali prodotto, piano, funzionalità, limitazione, documento e fonte. Una rappresentazione coerente evita che lo stesso termine indichi oggetti diversi in pagine differenti.
La scelta della tecnologia con cui esprimere questo vocabolario dipende dal contesto. In alcuni casi sono necessari RDF, OWL e controlli SHACL; in altri un modello JSON Schema integrato con un grafo a proprietà può offrire la disciplina sufficiente per il dominio considerato. È importante non confondere un semplice schema dati con tutte le capacità logiche di un’ontologia formale.
3. Un’architettura Graph RAG ibrida
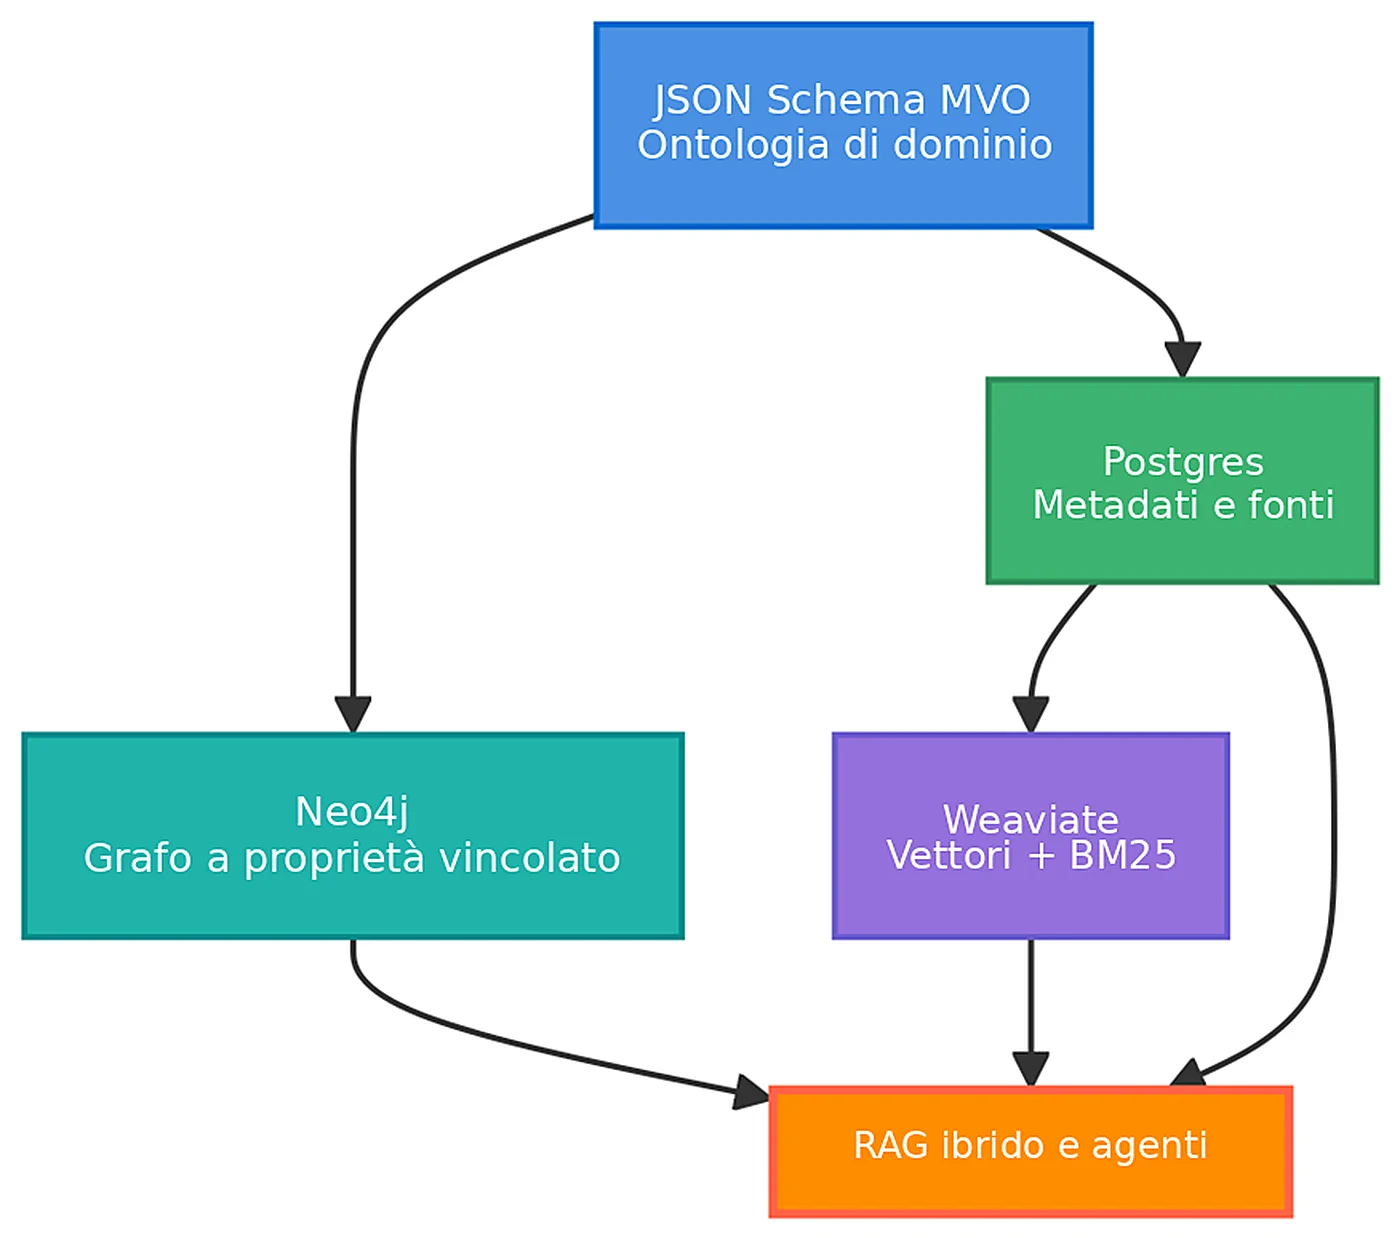
Un sistema aziendale può separare le responsabilità in diversi componenti: uno schema definisce le entità, un grafo conserva i collegamenti, un database relazionale registra le fonti, un motore di ricerca individua i contenuti pertinenti e il livello RAG orchestra le verifiche.
Nel caso descritto da Massimiliano Geraci, il disegno applicativo utilizza JSON Schema, Neo4j, Postgres e Weaviate. Non si tratta dell’unica combinazione possibile: il valore dipende dal ruolo assegnato a ogni componente e dalla qualità delle interfacce che li tengono sincronizzati.
4. JSON Schema come ontologia minima funzionale
In un dominio SaaS la base può essere un modello strutturato che descrive identità della piattaforma, piani e prezzi, funzionalità, integrazioni, sicurezza e assistenza. JSON Schema consente di esprimere campi, tipi, vincoli e organizzazione dei dati in un formato verificabile dal software.
Un’informazione importante non dovrebbe limitarsi al valore riportato in una pagina commerciale. È utile conservarne anche fonte, momento di acquisizione, eventuale scadenza e motivazione dell’estrazione. Una capacità dichiarata oggi può non essere disponibile in una versione precedente o in un mercato specifico.
Questa impostazione rappresenta un’ontologia minima funzionale per un ambito delimitato: un vocabolario applicativo capace di ridurre le ambiguità operative. Non equivale automaticamente all’espressività logica di RDF/OWL, ma può essere una scelta concreta quando il perimetro è controllato.
5. Neo4j: un grafo a proprietà con regole precise
Nel grafo possiamo distinguere società, prodotti, piani, funzionalità, limiti, standard di conformità e fatti documentati. Le relazioni indicano, per esempio, che un prodotto offre un piano o che un piano supporta una determinata funzione.
Per evitare informazioni ambigue, ogni fatto dovrebbe essere associato a metadati di affidabilità e di validità temporale. In questo modo si possono eseguire interrogazioni specifiche: quali piani includono una funzione oggi? Quali limitazioni si applicano ai clienti di una certa giurisdizione? Da quale documento deriva l’affermazione?
LPG è il modello di dati; Neo4j è uno dei prodotti che lo implementano. Tenere distinta questa terminologia aiuta a valutare anche implementazioni e standard diversi.
6. Postgres e la provenienza delle informazioni
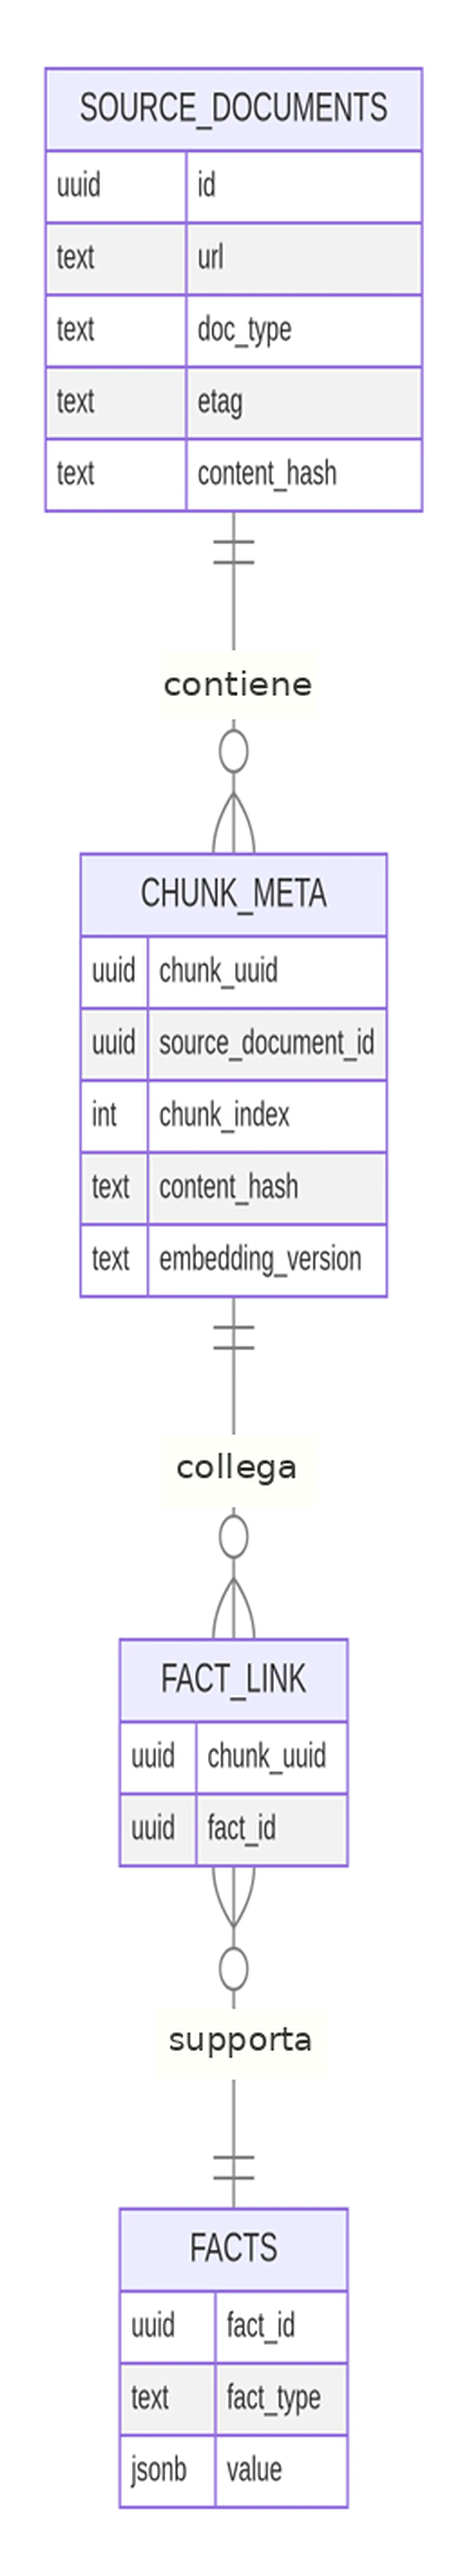
La provenienza dei dati, o data provenance, riguarda la possibilità di risalire all’origine di ogni informazione utilizzata dal sistema. Un database relazionale può conservare documenti, versioni, frammenti di testo, identificativi e collegamenti ai fatti contenuti nel grafo.
Quando una pagina cambia, l’architettura può individuare i contenuti aggiornati attraverso identificativi e impronte del contenuto, come un content_hash. Non è necessario presumere che l’intero catalogo sia cambiato: si possono rielaborare i soli documenti coinvolti, riestrarre i fatti e aggiornare le relazioni pertinenti.
Questa gestione del ciclo di vita è fondamentale nei settori in cui prezzi, politiche commerciali e requisiti evolvono frequentemente. Una risposta apparentemente corretta ma basata su dati scaduti può essere più pericolosa di un’esplicita dichiarazione di incertezza.
7. Weaviate e il recupero ibrido delle informazioni
Una volta modellata la conoscenza occorre trovare rapidamente i passaggi utili alla domanda. Weaviate permette di combinare ricerca vettoriale e ricerca lessicale BM25, con filtri sui metadati.
Questa ricerca ibrida sfrutta la capacità degli embedding di riconoscere somiglianze semantiche e la precisione dei termini espliciti quando nomi di prodotto, codici o requisiti devono corrispondere esattamente. I risultati costituiscono una rosa di candidati, non ancora una risposta verificata.
8. Dal recupero alla risposta: la fusione gerarchica
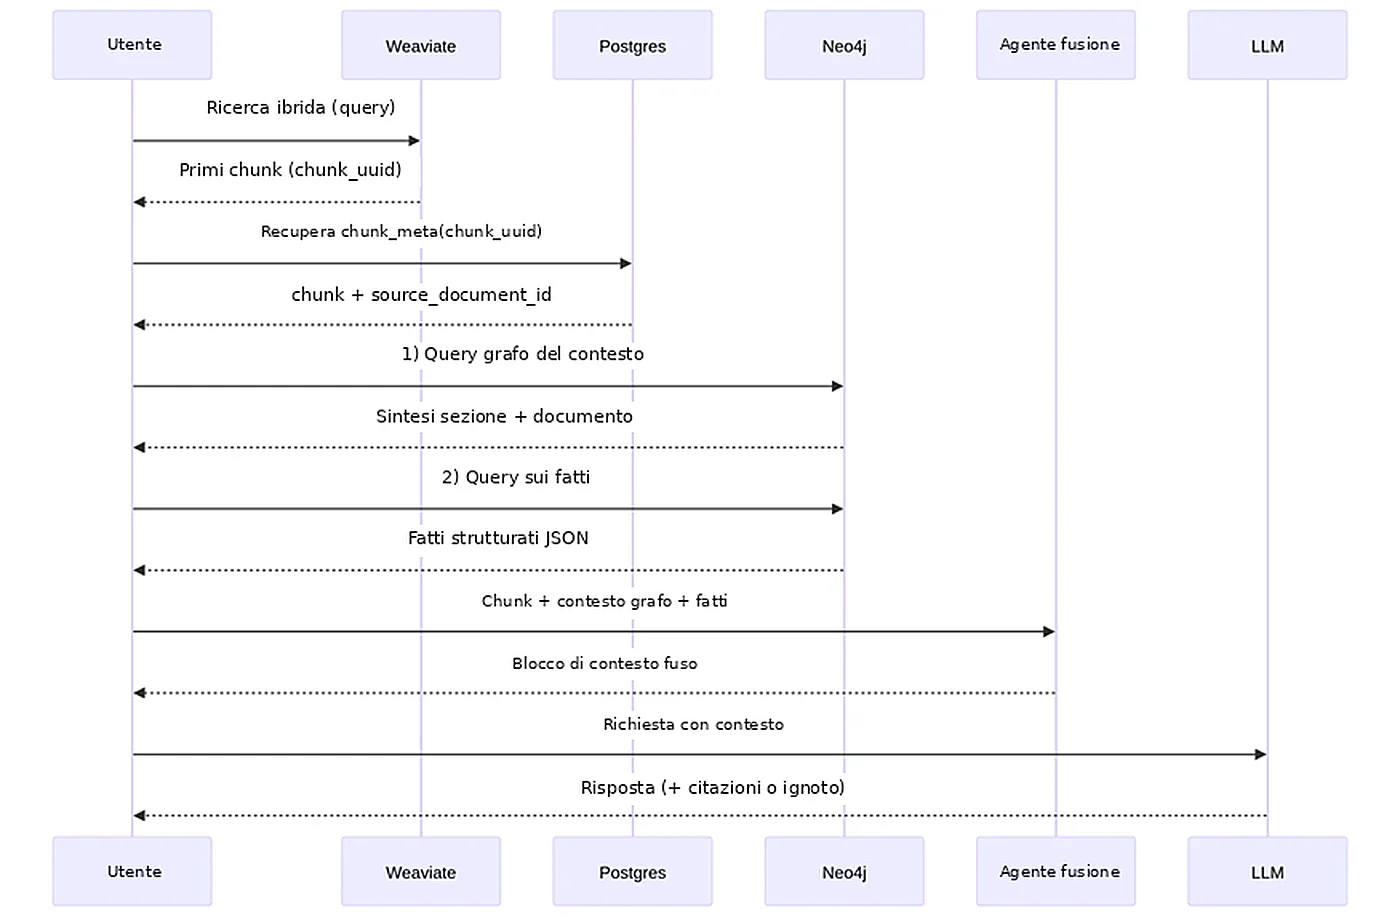
Il passaggio decisivo consiste nell’unire frammenti testuali, contesto documentale e fatti strutturati. È qui che il Graph RAG si distingue da una pipeline che invia direttamente a un LLM i primi risultati della ricerca.
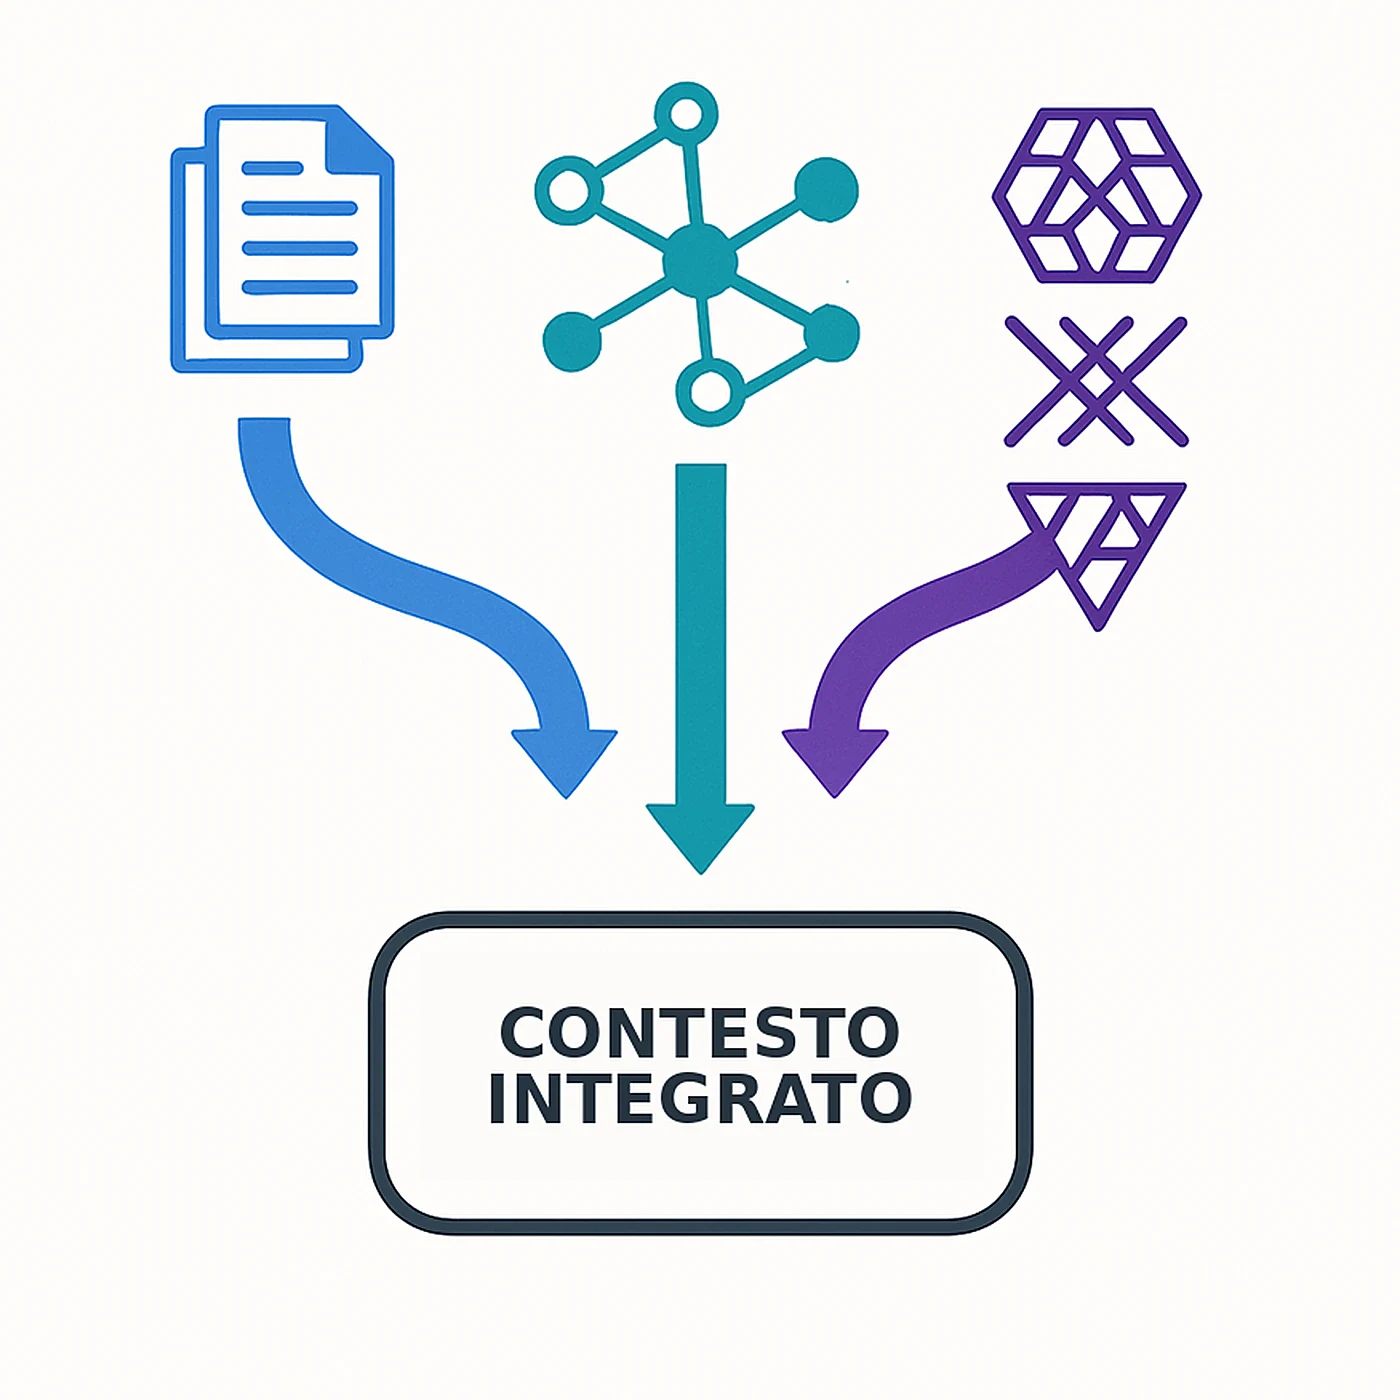
8.1 Individuare i passaggi pertinenti
Il motore di ricerca propone i frammenti più rilevanti per la domanda, filtrando quando possibile per prodotto, lingua o mercato. Questi risultati possono contenere un’informazione utile, ma non rappresentano ancora il quadro completo.
8.2 Ricostruire il contesto
Gli identificativi dei frammenti permettono di risalire alla sezione e al documento di origine. Il grafo collega quel documento ai prodotti e ai piani cui si riferisce. Una frase su un abbonamento non viene così attribuita automaticamente a un altro.
8.3 Recuperare i fatti validi
Il sistema interroga anche le informazioni strutturate: capacità dichiarate, limitazioni, date di validità, livello di confidenza e riferimenti. Se il dato è già scaduto, deve essere trattato come tale.
8.4 Allineare le evidenze
Prima della generazione, i contenuti possono essere sottoposti a controlli di coerenza. Se un frammento riporta il prezzo di un piano diverso, o contraddice una fonte aggiornata, deve essere scartato o segnalato. Il contesto destinato all’LLM dovrebbe contenere soltanto i passaggi utili e verificabili.
8.5 Rispondere oppure dichiarare l’incertezza
Una buona architettura prevede anche la possibilità di astenersi dalla risposta. Se le prove disponibili non superano una soglia di affidabilità, il sistema può indicare che non esistono informazioni sufficienti. Questa scelta è particolarmente importante per affermazioni su conformità, sicurezza, contratti e condizioni economiche.
9. RDF o LPG: come orientare la scelta
RDF è particolarmente interessante quando bisogna integrare vocabolari condivisi, pubblicare linked data o applicare regole formali e controlli coerenti con standard aperti. I grafi a proprietà sono spesso efficaci quando servono traversamenti rapidi, dati applicativi che cambiano spesso e interrogazioni leggibili dagli sviluppatori.
Questa non è una distinzione assoluta: le tecnologie evolvono e le possibilità di modellazione possono sovrapporsi. È preferibile partire dai requisiti dell’organizzazione, dalla necessità di interoperabilità e dalle verifiche che il sistema deve saper eseguire.
Un’architettura può anche esporre una parte delle proprie informazioni in RDF pur mantenendo un grafo a proprietà come sistema operativo. L’interoperabilità richiede progettazione esplicita e non deriva automaticamente dalla presenza di un determinato database.
10. Quattro domande per progettare il Graph RAG
Qual è il modello minimo del dominio?
Occorre individuare gli oggetti indispensabili e le relazioni che servono davvero alle domande degli utenti. Modellare tutto fin dall’inizio può aumentare il costo di manutenzione senza migliorare proporzionalmente il risultato.
Quali vincoli richiedono inferenza formale?
Se il sistema deve comporre regole normative complesse, strumenti RDF/OWL e controlli specifici possono essere appropriati. Se deve soprattutto collegare prodotti, piani e funzioni, potrebbe essere sufficiente una struttura tipizzata con verifiche applicative.
Quanto spesso cambiano i dati?
Un catalogo commerciale aggiornato ogni settimana ha esigenze diverse da un vocabolario stabile. Versionamento, provenienza e aggiornamenti selettivi devono essere dimensionati di conseguenza.
Come deve comportarsi il sistema quando manca una prova?
Prima di scegliere il database, conviene definire come il prodotto segnalerà fonti, limiti, contraddizioni e incertezza. La qualità della risposta dipende anche da queste decisioni operative.
11. Graph RAG e semantica ibrida: la qualità delle risposte viene prima degli strumenti
Il Graph RAG può utilizzare embedding, grafi e metadati per rispondere a domande che richiedono sia recupero di documenti sia verifica delle relazioni. L’aspetto centrale è mantenere chiara la responsabilità di ogni livello: trovare contenuti, inquadrarli nel dominio, controllare i fatti e produrre una risposta sostenuta da evidenze.
L’adozione di RDF, LPG o strumenti vettoriali non dovrebbe diventare un obiettivo autonomo. Il risultato da misurare è la capacità del sistema di fornire informazioni aggiornate, comprensibili e rintracciabili, riconoscendo con trasparenza i casi in cui i dati non bastano.
Approfondimento editoriale in italiano basato sui temi discussi da Massimiliano Geraci nell’articolo Beyond RDF vs LPG: Operational Ontologies, Hybrid Semantics, and Why We Still Chose a Property Graph. Questa versione è una rielaborazione autonoma, non una traduzione letterale dell’originale.