


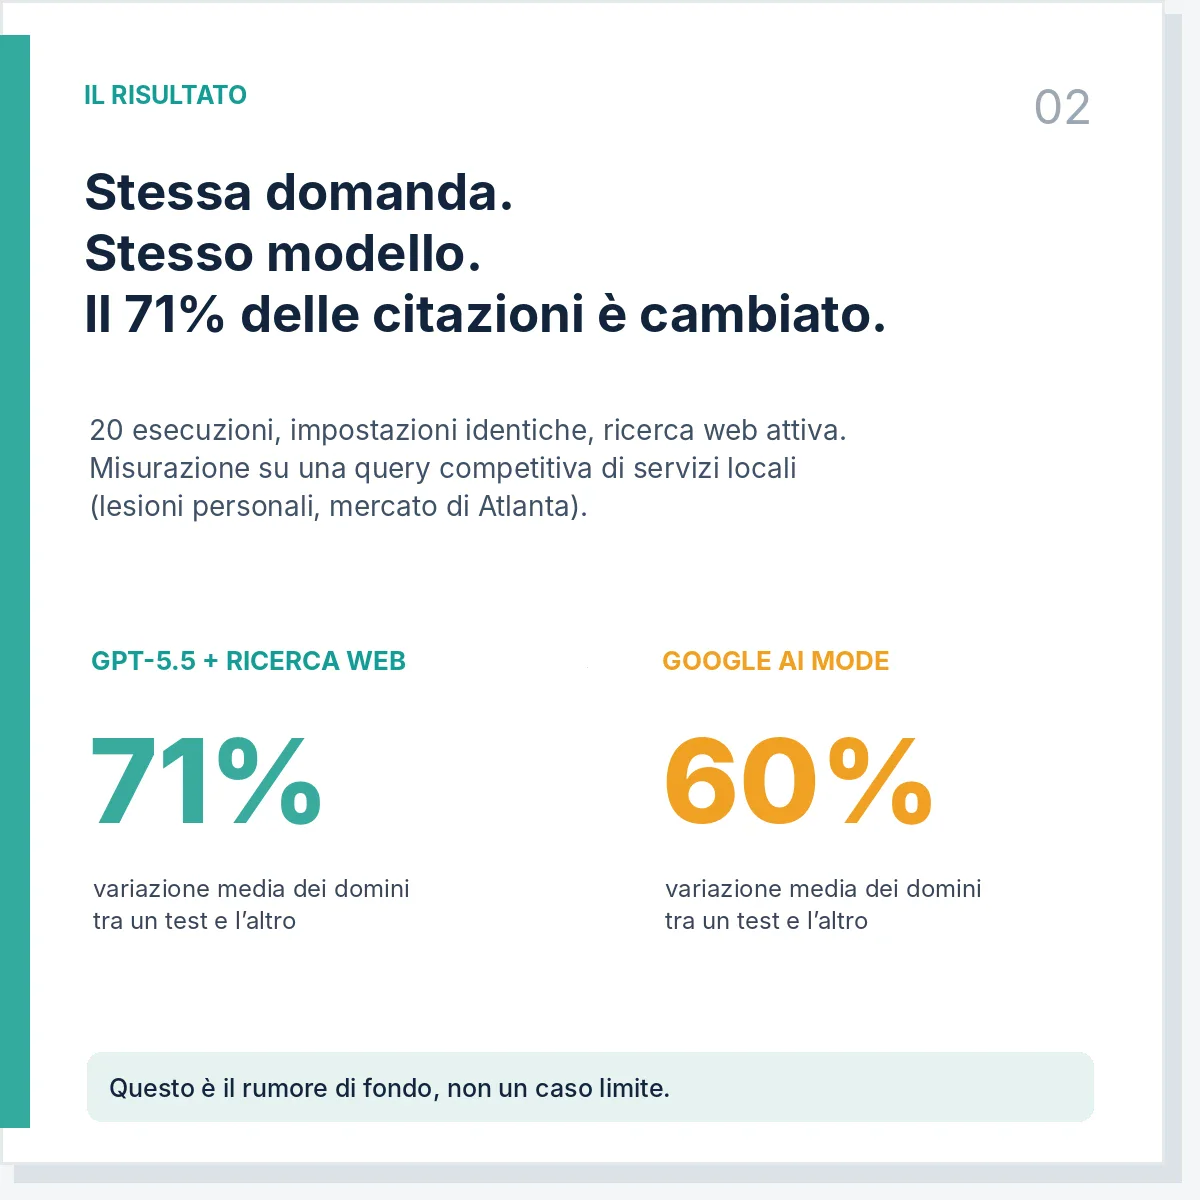
Abbiamo posto la stessa domanda a un motore AI 20 volte. Il 71% delle sue citazioni AI è cambiato.


Stessa domanda. Stesso modello. Stesse impostazioni, fissate e registrate fino al valore del livello di ragionamento (reasoning effort) nei dati della richiesta.
Venti ripetizioni.
Tra due esecuzioni qualsiasi, in media, il 71% dei domini citati era diverso.
Questo numero rappresenta il livello di rumore di fondo di GPT-5.5 con ricerca web, misurato su un insieme di query competitive relative a servizi locali nel settore del risarcimento per lesioni personali, nell’area di Atlanta.
Google AI Mode ha registrato il 60% con lo stesso protocollo.
Non si trattava di prompt avversariali particolari. Erano le semplici domande commerciali alle quali ogni brand oggi vorrebbe essere la risposta:
- «Il miglior X»
- «Y con le migliori valutazioni»
Se stai guardando una dashboard che ti dice quali siti un motore AI ha citato questa settimana, dovresti sapere su cosa si basa quella misurazione.
Perché abbiamo misurato il rumore di fondo prima di misurare qualsiasi altra cosa
Non ci eravamo proposti di misurare il rumore.
Volevamo rispondere a una domanda specifica sulla configurazione della misurazione: quando si misura la visibilità nella ricerca AI di un brand locale, la località dovrebbe comparire nel testo della query — per esempio, «miglior avvocato per lesioni personali ad Atlanta» — oppure nel parametro di localizzazione dell’API, lasciando il testo della query semanticamente pulito?
Due ingegneri ragionevoli potrebbero discutere per un’ora a favore dell’una o dell’altra soluzione. Volevamo mettere fine alla discussione.
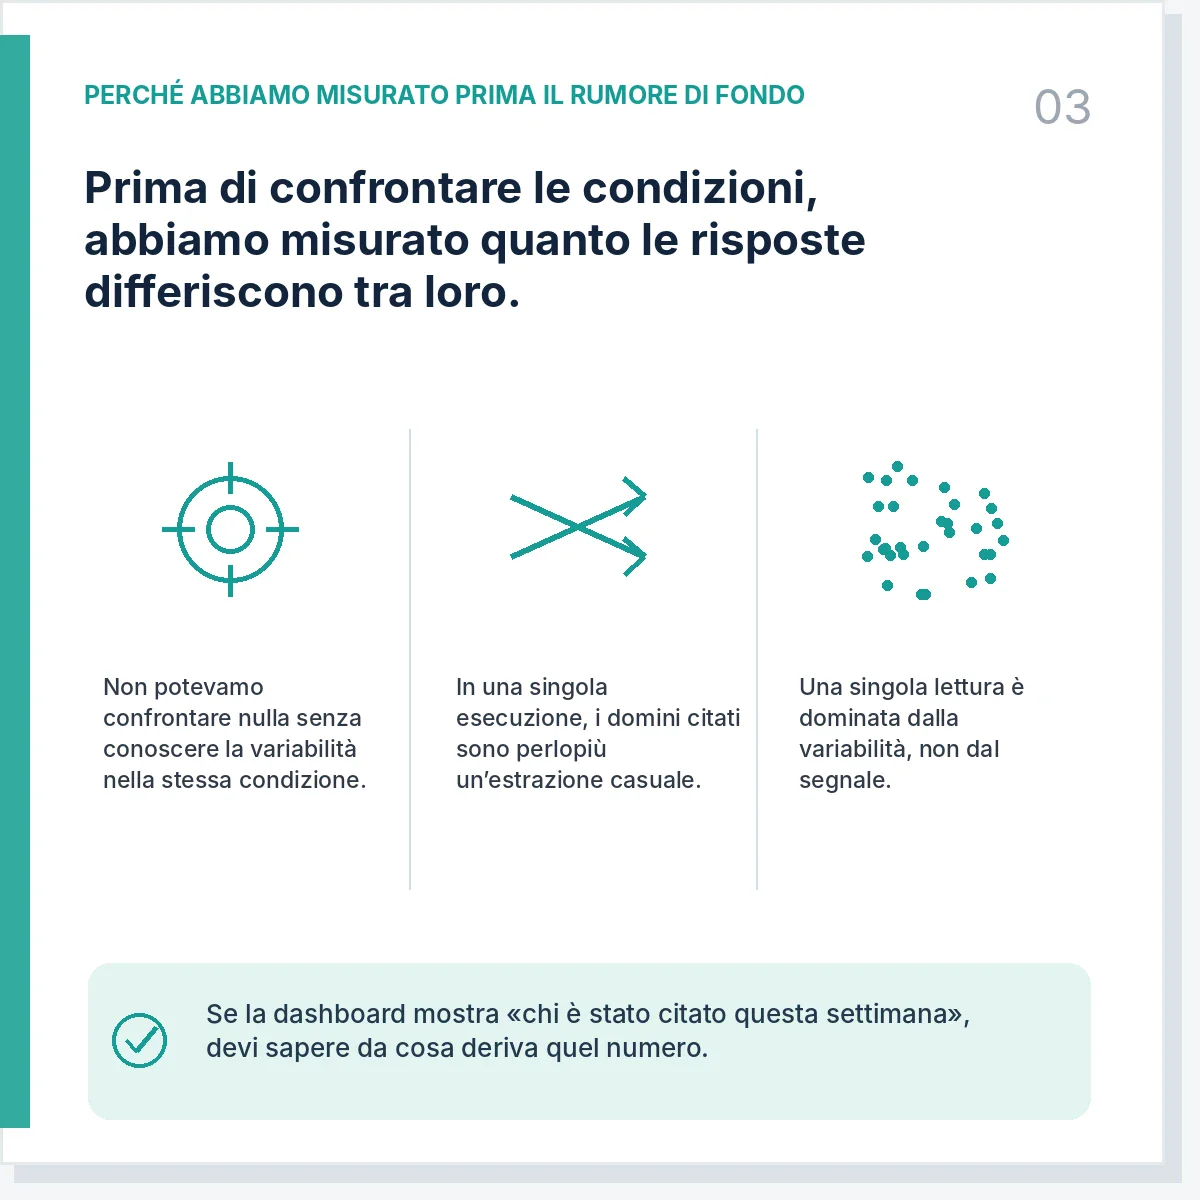
Ma un confronto tra condizioni diverse può essere interpretato soltanto alla luce della variabilità all’interno della stessa condizione. E quasi nessuno pubblica la variabilità interna delle risposte prodotte dai motori AI.
Per questo la prima fase dell’esperimento, secondo una regola preregistrata, non poteva confrontare assolutamente nulla.
Poteva soltanto ripetere più volte una stessa condizione e misurare quanto le risposte fossero in disaccordo tra loro.
Erano molto discordanti.
A livello di singola esecuzione, l’insieme dei domini citati era perlopiù un’estrazione casuale. Qualsiasi lettura basata su una sola esecuzione di «chi è stato citato» — la tua, la nostra o quella di chiunque altro — era dominata dalla variabilità, non dal fenomeno che si presumeva di misurare.
L’aggregazione funziona. Possiamo quantificare quanto.
Il fatto che il risultato di una singola esecuzione sia rumoroso non significa che il fenomeno sia impossibile da misurare.
Significa che è sbagliata la grandezza che si cerca di stimare.
L’oggetto stabile non è:
«I domini citati in una singola esecuzione».
L’oggetto stabile è:
La distribuzione dei domini citati tra più esecuzioni: quali domini compaiono, con quale frequenza, aggregando osservazioni ripetute.
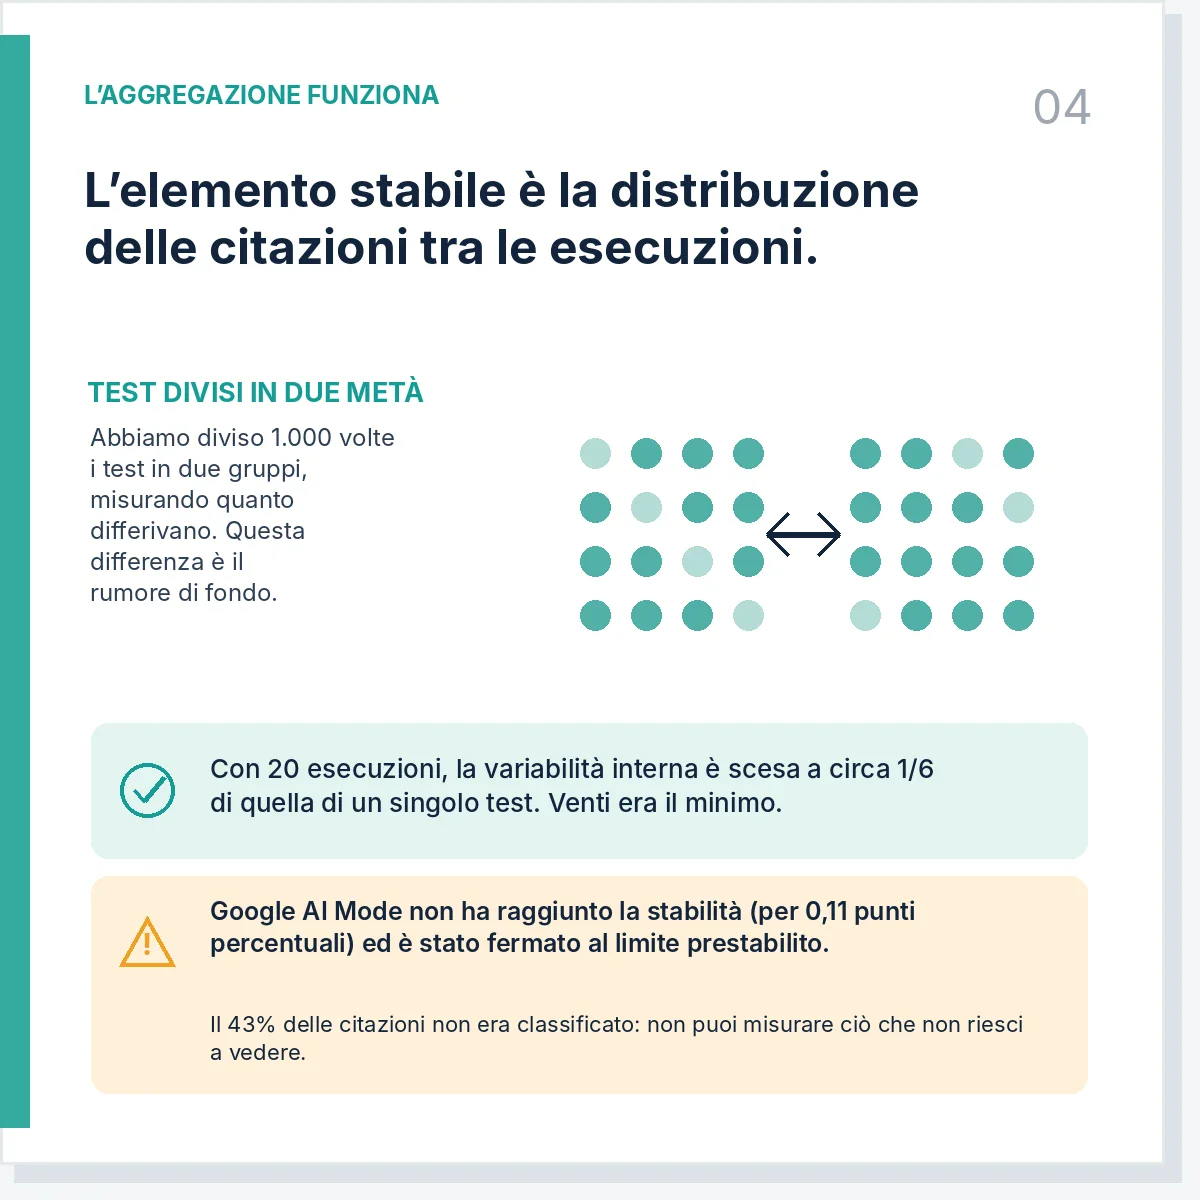
Abbiamo misurato quanto rapidamente questa distribuzione si stabilizzi utilizzando un test split-half.
Per ogni test, abbiamo diviso casualmente le ripetizioni in due metà per mille volte e misurato quanto le distribuzioni risultanti differissero tra loro.
Questa differenza è il rumore di fondo. È incorporata direttamente nel test, invece di essere stimata osservando un grafico e dichiarandolo sufficientemente stabile perché tutti vorrebbero tornare a casa.
Con venti ripetizioni per query, il disaccordo interno alla distribuzione aggregata è sceso a circa un sesto rispetto al livello della singola esecuzione.
Venti esecuzioni erano anche, a essere sinceri, il minimo. Il rumore di fondo stava ancora diminuendo quando ha oltrepassato la nostra soglia di stabilità preregistrata, durante l’ultimo ciclo consentito.
Una delle piattaforme non ha mai raggiunto quella soglia.
Google AI Mode non ha soddisfatto il criterio di stabilità al limite massimo di ripetizioni, per uno scarto di 0,11 punti percentuali.
La regola preregistrata imponeva di fermarsi, quindi ci siamo fermati, e quella piattaforma è uscita dall’esperimento.
Una regola che si piega per un risultato mancato di poco non è una regola.
Vale la pena spiegare il motivo più profondo di questa difficoltà: il 43% delle fonti citate da AI Mode non rientrava nella copertura del nostro sistema di classificazione delle fonti.
Non puoi caratterizzare una distribuzione se riesci a vederne soltanto metà.
Per quella piattaforma, il vero collo di bottiglia era la copertura della tassonomia, non la statistica.
La risposta alla domanda originale
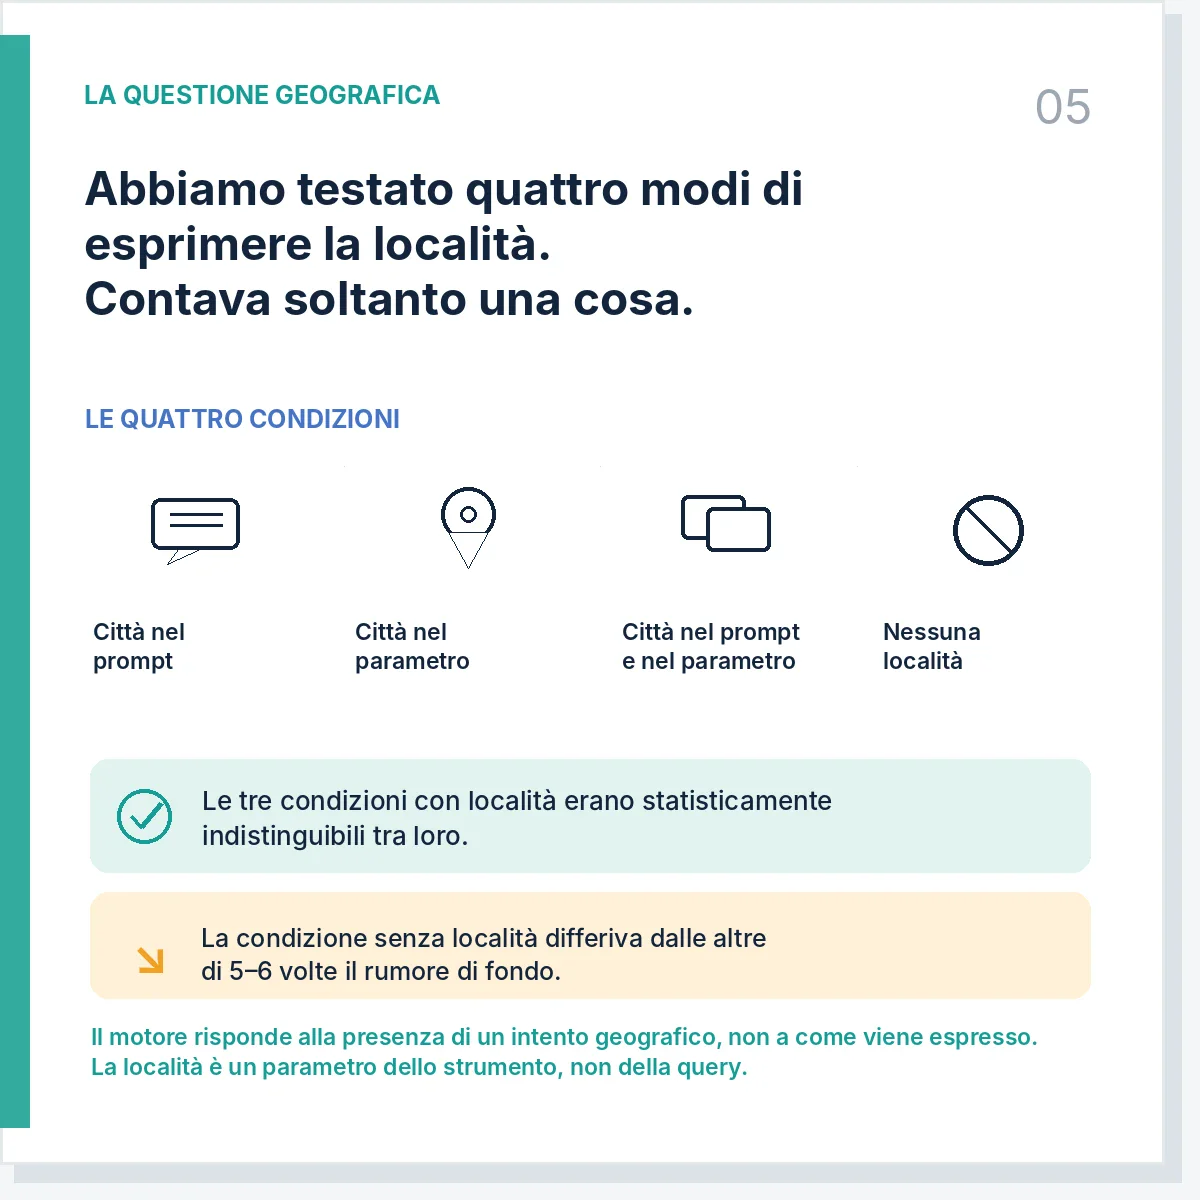
Una volta incorporato il rumore di fondo all’interno del test, la questione della localizzazione geografica è diventata un esperimento a quattro condizioni:
- Località nel testo della query
- Località nel parametro dell’API
- Località sia nella query sia nel parametro
- Nessuna località indicata
Abbiamo utilizzato sei query, venti ripetizioni per query e verificato con test la struttura di ogni payload prima di effettuare una sola chiamata a pagamento.
Il risultato è stato netto.
Le tre condizioni che includevano informazioni geografiche erano statisticamente indistinguibili l’una dall’altra.
La divergenza tra «città nel prompt» e «città nel parametro» rientrava ampiamente nel rumore interno alla stessa condizione:
- Divergenza osservata: 0,094
- Rumore di fondo all’interno della condizione: 0,131
Anche la sovrapposizione dei domini più citati e la composizione delle categorie di fonti sono rimaste all’interno delle rispettive distribuzioni nulle.
Nel frattempo, la condizione senza informazioni geografiche si è distinta da tutte e tre le condizioni geografiche con una differenza pari a circa cinque-sei volte il rumore di fondo.
Letti insieme, questi due risultati dicono qualcosa di preciso:
Il recupero delle informazioni da parte del motore risponde fortemente alla presenza di un intento geografico, ma non al modo in cui viene espresso.
La località è quindi un parametro dello strumento di misurazione, non un parametro della query.
Ora manteniamo il testo della query semanticamente pulito e passiamo le informazioni geografiche attraverso l’API. Qualsiasi raccolta futura che inserisca una città nel prompt deve prevedere un’eccezione esplicita che identifichi la specifica tecnica che la giustifica.
La decisione è applicata nel codice, non soltanto documentata.
Due cose che non stavamo cercando
Il registro dei costi ha rivelato un risultato relativo al funzionamento del meccanismo.
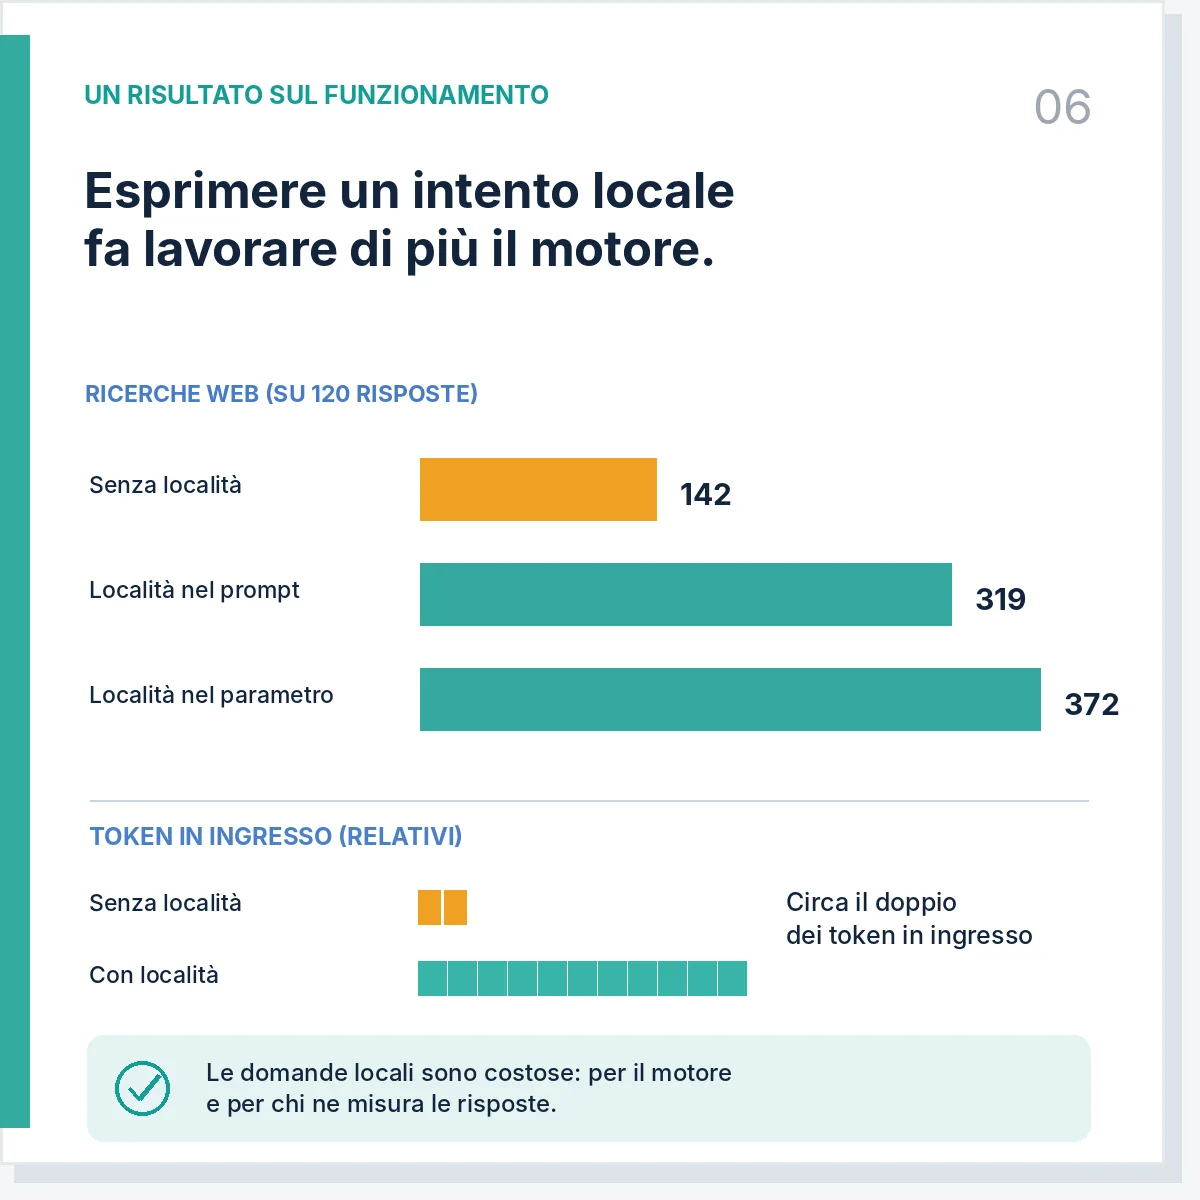
La condizione senza informazioni geografiche ha generato 142 chiamate di ricerca web su 120 risposte.
Le condizioni con informazioni geografiche hanno generato 319 e 372 chiamate di ricerca web, con un utilizzo di token in input all’incirca doppio.
Esprimere un intento locale porta il motore a effettuare un’attività di recupero delle informazioni approssimativamente doppia.
Le domande locali sono domande costose, sia per il motore sia per chi cerca di misurarne il comportamento.
La sonda di controllo ha prodotto il comportamento più rassicurante dell’intero insieme di dati.
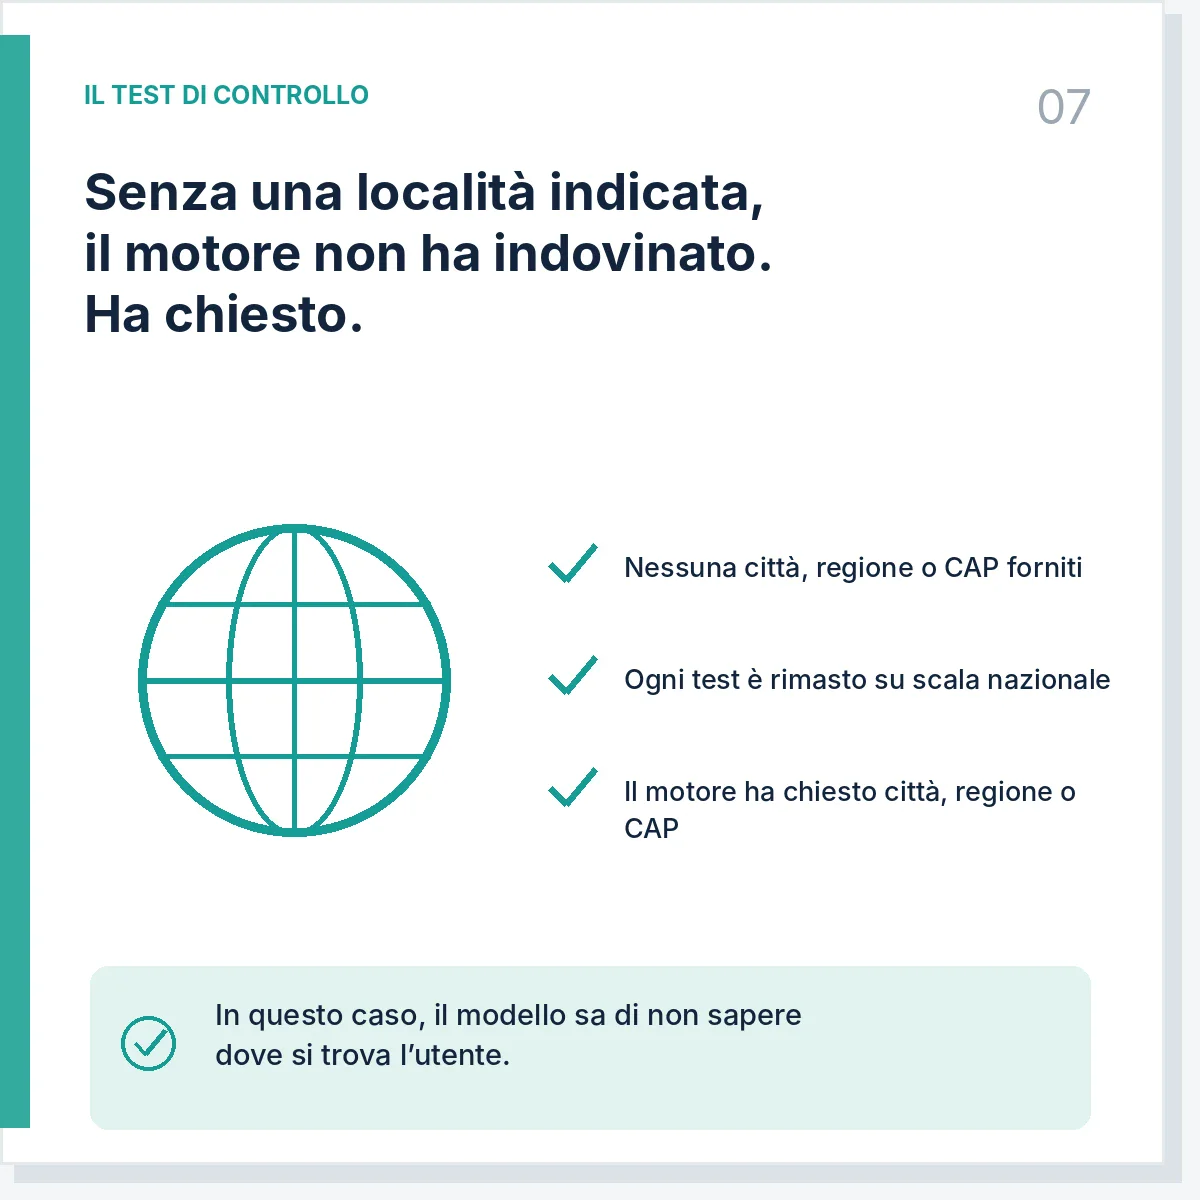
Quando non veniva fornita alcuna località, il motore non deduceva silenziosamente un’area metropolitana dall’indirizzo IP dell’utente, dai dati dell’account o da altri segnali contestuali nascosti.
In ogni esecuzione della sonda, manteneva una prospettiva nazionale e chiedeva all’utente di fornire una città, uno stato o un codice postale (ZIP code).
Su questa piattaforma, almeno, il modello sapeva ciò che non sapeva riguardo alla località dell’utente.
Cosa significa per chi acquista o sviluppa sistemi di misurazione della visibilità nell’AI
Ci sono tre domande che vale la pena porre riguardo a qualsiasi numero che pretenda di descrivere la presenza di un brand nelle risposte AI.
- Su quante ripetizioni è aggregato quel numero?
- Qual è il livello di rumore di fondo all’interno della stessa condizione?
- Quale frazione dell’universo delle fonti citate non viene classificata dal sistema di classificazione?
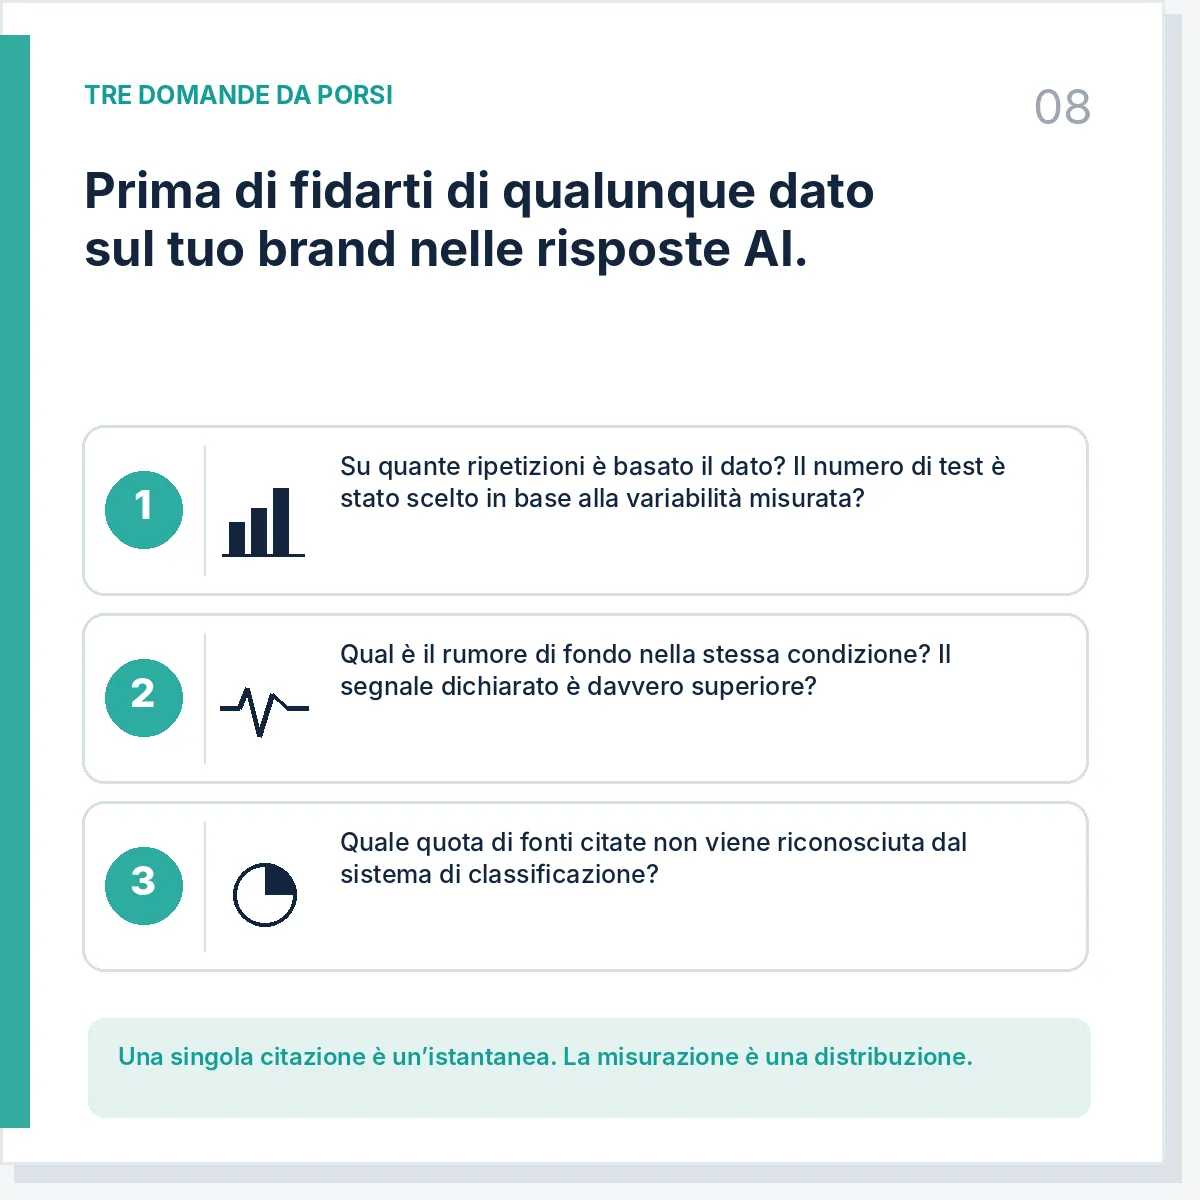
Uno screenshot delle citazioni tratto da una singola esecuzione è un’estrazione da una distribuzione, presentata come se fosse la distribuzione stessa.
L’estrazione cambia tra il 60% e il 71% delle volte, anche quando nient’altro cambia.
La distribuzione, invece, è misurabile, stabile e vale la pena pagare per misurarla.
La differenza tra le due è la differenza tra misurazione e decorazione.
Il protocollo completo — regole decisionali preregistrate, distribuzioni nulle ottenute con test split-half, seed deterministici e condizioni di arresto scattate due volte contro la nostra stessa convenienza — esiste perché le risposte dei motori AI sono abbastanza volatili da permettere ai ricercatori di trovare esattamente ciò che erano venuti a cercare.
Il rigore metodologico è il prodotto.
Note metodologiche: Accesso diretto a OpenAI utilizzando GPT-5.5 con ricerca web e a Google AI Mode attraverso un provider di dati autorizzato. Sei query × quattro condizioni sperimentali × venti ripetizioni. Livello di ragionamento (reasoning effort) esplicitamente fissato e registrato direttamente dai dati di ogni richiesta per ciascuna osservazione. Divergenza di Jensen–Shannon calcolata sulle distribuzioni aggregate dei domini citati e valutata rispetto a distribuzioni nulle split-half, utilizzando 1.000 suddivisioni casuali, un seed fisso e il 95° percentile calcolato con il metodo nearest-rank. Le righe corrispondenti a errori del provider sono state escluse da entrambe le parti e mai sostituite. Tutte le statistiche sono state calcolate in Python a partire dalle risposte grezze archiviate e riprodotte in modo identico byte per byte durante una verifica indipendente.